
La medicina atraviesa una transformación silenciosa pero profunda, impulsada no por el descubrimiento de un nuevo fármaco ni por una técnica quirúrgica inédita, sino por líneas de código capaces de aprender. La integración de la inteligencia artificial (IA) en el sector de la salud ha dejado de ser una especulación futurista para convertirse en una realidad operativa dentro de hospitales, laboratorios y centros de diagnóstico de todo el mundo.
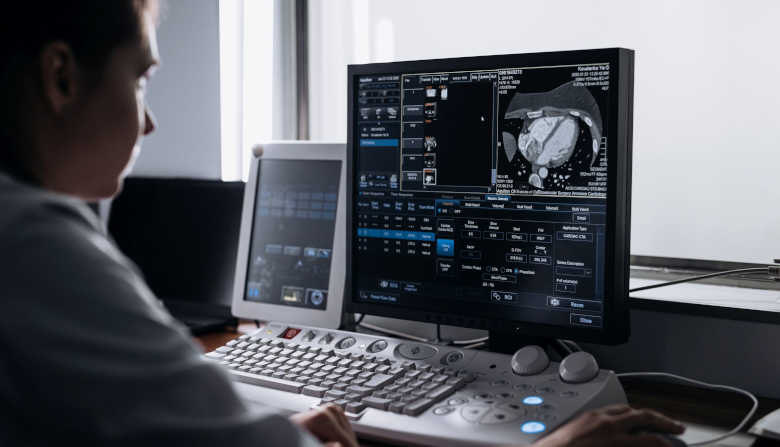
El verdadero motor de esta revolución radica en la capacidad de los algoritmos de aprendizaje profundo (deep learning) para procesar e interpretar volúmenes masivos de datos biomédicos a una velocidad inalcanzable para la mente humana. En el área del diagnóstico por imágenes, como radiografías, resonancias magnéticas, tomografías computarizadas y mamografías, las redes neuronales convolucionales han demostrado una precisión extraordinaria.
Son capaces de detectar patrones sutiles, microcalcificaciones imperceptibles o pequeños nódulos pulmonares en etapas extremadamente tempranas, donde la intervención médica cambia radicalmente el pronóstico del paciente. Sin embargo, el alcance de la tecnología va mucho más allá de la radiología.
En el ámbito de la medicina de precisión, la IA permite cruzar datos genómicos, antecedentes familiares y registros clínicos para predecir la respuesta de un individuo a tratamientos específicos, abriendo la puerta a terapias personalizadas, particularmente en oncología. Asimismo, en el área farmacológica, los modelos predictivos están acortando de años a meses la fase inicial de búsqueda y diseño de moléculas para nuevos medicamentos, optimizando costos y acelerando la llegada de soluciones a enfermedades complejas.
A pesar de las promesas de eficiencia y mayor cobertura sanitaria, la adopción masiva de estos sistemas plantea interrogantes éticos, técnicos y legales de gran envergadura. Uno de los problemas más apremiantes es el sesgo en los datos de entrenamiento. Si un algoritmo se nutre mayoritariamente de historiales clínicos de una población urbana o de un grupo étnico determinado, sus predicciones pueden perder precisión o generar errores sistemáticos al aplicarse en comunidades subrepresentadas, profundizando las brechas de inequidad en el acceso a la salud.
A esto se suma el desafío de la denominada «caja negra» (black box). Gran parte de los modelos de aprendizaje profundo ofrecen resultados altamente precisos, pero sus procesos internos de razonamiento resultan impenetrables incluso para sus propios desarrolladores. Para un médico, aceptar una recomendación diagnóstica o terapéutica emitida por un sistema que no puede explicar el porqué de su decisión plantea un dilema profesional y ético insoslayable, dado que la responsabilidad última del acto médico recae sobre el ser humano.
En el terreno legal, la asignación de responsabilidades ante un error diagnóstico asistido por IA constituye un vacío normativo en constante debate. Si un algoritmo pasa por alto una lesión maligna o sugiere un tratamiento inadecuado, surge la duda sobre quién debe asumir las consecuencias jurídicas. La respuesta requiere marcos regulatorios actualizados que definan los límites de la responsabilidad y los estándares de validación clínica exigibles a estas herramientas antes de su comercialización.
Por último, la seguridad y la privacidad de los datos sensibles de los pacientes representan una prioridad crítica. La masa crítica de información requerida para entrenar y perfeccionar estos modelos exige protocolos de encriptación y anonimización de máximo nivel para blindar las historias clínicas frente a ciberataques o usos comerciales no autorizados.